Hadoop 学习总结
Hadoop 学习总结。
hadoop 架构
hadoop1.0 与 2.0、3.0 架构的变化。
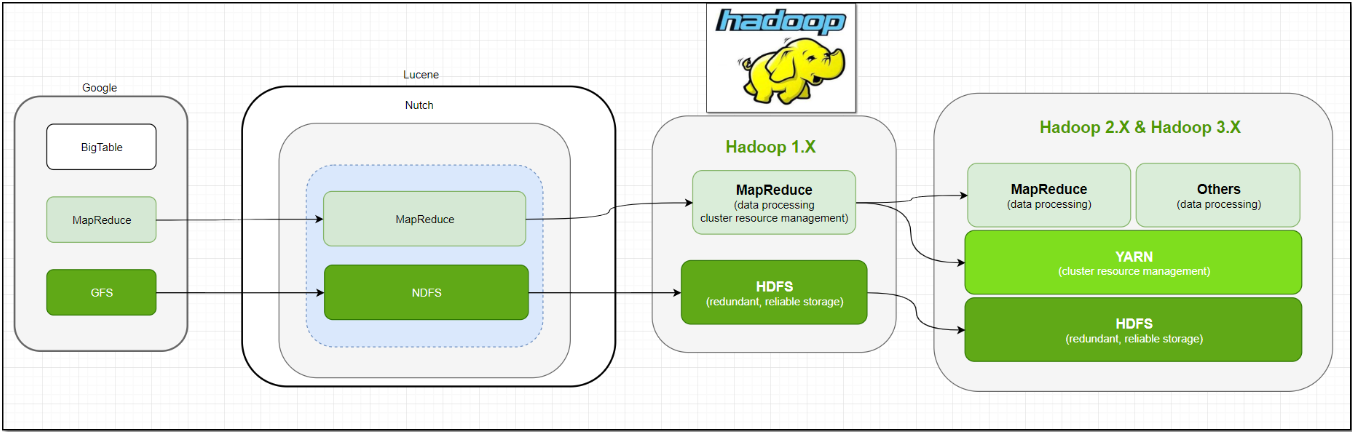
Hadoop 由三个模块组成:
- 分布式存储 HDFS
- 分布式计算 MapReduce
- 资源调度引擎 Yarn
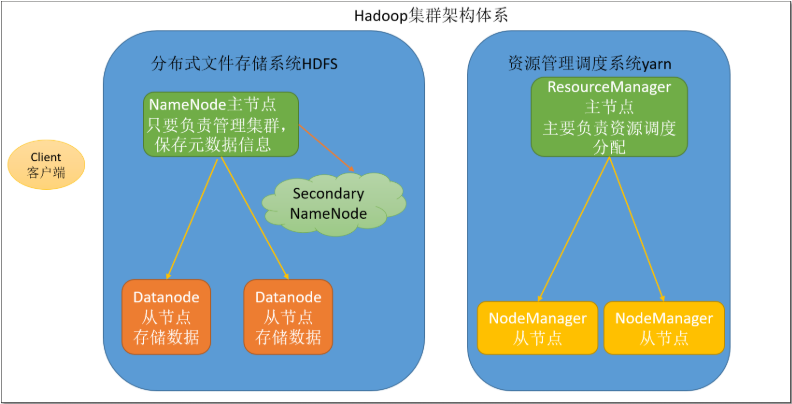
主从中的各个角色:
-
HDFS 模块主从架构:
- namenode:主节点,主要负责集群的管理以及元数据信息管理
- datanode:从节点,主要负责存储用户数据
- secondaryNameNode:辅助 namenode 管理元数据信息,以及元数据信息的冷备份
-
Yarn 模块:
- ResourceManager:主节点,主要负责资源分配
- NodeManager:从节点,主要负责执行任务
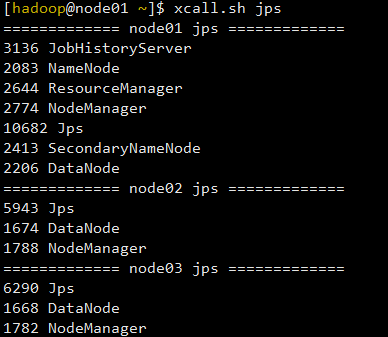
一个三结点的 Hadoop 集群各个角色线程运行情况。
HDFS
HDFS 是 Hadoop 的分布式文件系统。在 HDFS 中文件以 block 块为单位存储,在集群中 block 会保存多份副本。新版本的 Hadoop 支持机架感知,如果进行设置,block 会被均匀分配存储到不同的机架上,最大限度避免物理故障对数据造成影响。
分块存储、副本
分块存储
- 保存文件到 HDFS 时,会先默认按 128M 的单位对文件进行切分成一个个block 块
- 数据以 block 块的形式存在 HDFS 文件系统中
- 在 hadoop1 当中,文件的 block 块默认大小是 64M
- hadoop2 当中,文件的 block 块大小默认是 128M,block 块的大小可以通过 hdfs-site.xml 当中的配置文件进行指定
1<property>
2    <name>dfs.blocksize</name>
3    <value>块大小 以字节为单位</value><!-- 只写数值就可以 -->
4</property>
- block 块元数据(*.meta),每个 block 块对应一个元数据信息
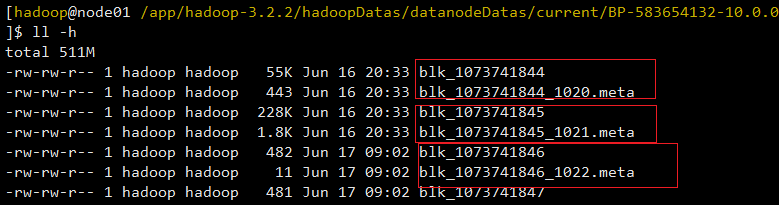
副本存储
- 为了保证 block 块的安全性,在 hadoop2 当中,采用文件默认保存三个副本,我们可以更改副本数以提高数据的安全性
- 在 hdfs-site.xml 当中修改以下配置属性,即可更改文件的副本数
1    <property>
2          <name>dfs.replication</name>
3          <value>3</value>
4    </property>
HDFS 架构
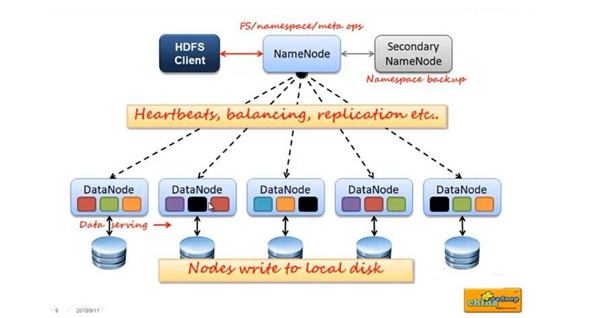
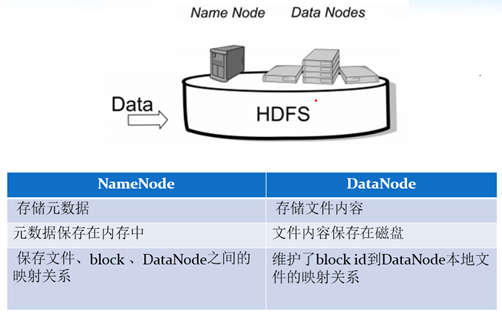
HDFS 集群包括,NameNode 和 DataNode 以及 Secondary Namenode。
- NameNode 负责管理整个文件系统的元数据,以及每一个路径(文件)所对应的数据块信息。
- DataNode 负责管理用户的文件数据块,每一个数据块都可以在多个 datanode 上存储多个副本。
- Secondary NameNode 用来监控 HDFS 状态的辅助后台程序,每隔一段时间获取 HDFS 元数据的快照。最主要作用是辅助 namenode 管理元数据信息
HDFS shell 命令
使用命令的方式,两种:
1hdfs dfs -help ls
2hadoop fs -help ls
HDFS 的 shell 命令与 Linux 命令很相似,可以通过帮助查看后使用,通过程序操作是也提供了与 shell 命令相似的方法。
输入 hadoop fs 或 hdfs dfs 查看帮助文档。
 1[hadoop@node01 /app/hadoop-3.2.2]$ hdfs dfs
 2Usage: hadoop fs [generic options]
 3	[-appendToFile <localsrc> ... <dst>]
 4	[-cat [-ignoreCrc] <src> ...]
 5	[-checksum <src> ...]
 6	[-chgrp [-R] GROUP PATH...]
 7	[-chmod [-R] <MODE[,MODE]... | OCTALMODE> PATH...]
 8	[-chown [-R] [OWNER][:[GROUP]] PATH...]
 9	[-copyFromLocal [-f] [-p] [-l] [-d] [-t <thread count>] <localsrc> ... <dst>]
10	[-copyToLocal [-f] [-p] [-ignoreCrc] [-crc] <src> ... <localdst>]
11	[-count [-q] [-h] [-v] [-t [<storage type>]] [-u] [-x] [-e] <path> ...]
12	[-cp [-f] [-p | -p[topax]] [-d] <src> ... <dst>]
13	[-createSnapshot <snapshotDir> [<snapshotName>]]
14	[-deleteSnapshot <snapshotDir> <snapshotName>]
15	[-df [-h] [<path> ...]]
16	[-du [-s] [-h] [-v] [-x] <path> ...]
17	[-expunge [-immediate]]
18	[-find <path> ... <expression> ...]
19	[-get [-f] [-p] [-ignoreCrc] [-crc] <src> ... <localdst>]
20	[-getfacl [-R] <path>]
21	[-getfattr [-R] {-n name | -d} [-e en] <path>]
22	[-getmerge [-nl] [-skip-empty-file] <src> <localdst>]
23	[-head <file>]
24	[-help [cmd ...]]
25	[-ls [-C] [-d] [-h] [-q] [-R] [-t] [-S] [-r] [-u] [-e] [<path> ...]]
26	[-mkdir [-p] <path> ...]
27	[-moveFromLocal [-f] [-p] [-l] [-d] <localsrc> ... <dst>]
28	[-moveToLocal <src> <localdst>]
29	[-mv <src> ... <dst>]
30	[-put [-f] [-p] [-l] [-d] [-t <thread count>] <localsrc> ... <dst>]
31	[-renameSnapshot <snapshotDir> <oldName> <newName>]
32	[-rm [-f] [-r|-R] [-skipTrash] [-safely] <src> ...]
33	[-rmdir [--ignore-fail-on-non-empty] <dir> ...]
34	[-setfacl [-R] [{-b|-k} {-m|-x <acl_spec>} <path>]|[--set <acl_spec> <path>]]
35	[-setfattr {-n name [-v value] | -x name} <path>]
36	[-setrep [-R] [-w] <rep> <path> ...]
37	[-stat [format] <path> ...]
38	[-tail [-f] [-s <sleep interval>] <file>]
39	[-test -[defswrz] <path>]
40	[-text [-ignoreCrc] <src> ...]
41	[-touch [-a] [-m] [-t TIMESTAMP ] [-c] <path> ...]
42	[-touchz <path> ...]
43	[-truncate [-w] <length> <path> ...]
44	[-usage [cmd ...]]
45
46Generic options supported are:
47-conf <configuration file>        specify an application configuration file
48-D <property=value>               define a value for a given property
49-fs <file:///|hdfs://namenode:port> specify default filesystem URL to use, overrides 'fs.defaultFS' property from configurations.
50-jt <local|resourcemanager:port>  specify a ResourceManager
51-files <file1,...>                specify a comma-separated list of files to be copied to the map reduce cluster
52-libjars <jar1,...>               specify a comma-separated list of jar files to be included in the classpath
53-archives <archive1,...>          specify a comma-separated list of archives to be unarchived on the compute machines
54
55The general command line syntax is:
56command [genericOptions] [commandOptions]
HDFS 优缺点
优点:
-
高容错性
- 数据自动保存多个副本。它通过增加副本的形式,提高容错性。
- 某一个副本丢失以后,它可以自动恢复,这是由 HDFS 内部机制自动实现
-
适合批处理
- 把数据位置暴露给计算框架,通过移动计算而不是移动数据,提高效率
-
适合大数据处理
- 数据规模:能够处理数据规模达到 GB、TB、甚至 PB 级别的数据。
- 文件规模:能够处理百万规模以上的文件数量,数量相当之大。
- 节点规模:能够处理 10K 节点的规模。
-
流式数据访问
- 一次写入,多次读取
- 不能随机修改,只能追加。
- 它能保证数据的一致性。
-
可构建在廉价机器上
- 它通过多副本机制,提高可靠性。
- 它提供了容错和恢复机制。比如某一个副本丢失,可以通过其它副本来恢复。
缺点:
-
不适合低延时数据访问;
- 比如毫秒级的来存储、读取数据,这是不行的,它做不到。
- 它适合高吞吐率的场景,就是在某一时间内写入大量的数据。
-
无法高效的对大量小文件进行存储
- 存储大量小文件的话,它会占用 NameNode 大量的内存来存储文件、目录和块信息。这样是不可取的,因为 NameNode 的内存总是有限的。
- 小文件存储的寻道时间会超过读取时间,它违反了 HDFS 的设计目标。
-
并发写入、文件随机修改
- 一个文件只能有一个写,不允许多个线程同时写(租约机制)。
- 仅支持数据 append(追加),不支持文件的随机修改。
Java 操作 HDFS
操作 HDFS 的核心接口是 FileSystem,通过这个类可以连接一个 hdfs 服务,然后进行操作。
 1    // 在hdfs中创建一个目录
 2    @Test
 3    public void hdfsTest() throws Exception {
 4        // configuration
 5        Configuration conf = new Configuration();
 6
 7        //conf.set("fs.defaultFS","hdfs://node01:8020");
 8
 9        // get filesystem
10        FileSystem fs = FileSystem.get(conf);
11
12        fs.mkdirs(new Path("/lqc/ideaTest"));
13
14        fs.close();
15
16    }
17
18    //指定目录所属用户
19    @Test
20    public void mkDirOnHDFS2() throws IOException, URISyntaxException, InterruptedException {
21        //配置项
22        Configuration configuration = new Configuration();
23
24        //获得文件系统
25        FileSystem fileSystem = FileSystem.get(new URI("hdfs://node01:8020"), configuration, "liuqichun");
26
27        //调用方法创建目录
28        boolean mkdirs = fileSystem.mkdirs(new Path("/lqc/dir2"));
29
30        //释放资源
31        fileSystem.close();
32    }
33
34
35    //创建目录时,指定目录权限
36    @Test
37    public void mkDirOnHDFS3() throws IOException {
38        Configuration configuration = new Configuration();
39        configuration.set("fs.defaultFS", "hdfs://node01:8020");
40
41        FileSystem fileSystem = FileSystem.get(configuration);
42        FsPermission fsPermission = new FsPermission(FsAction.ALL, FsAction.READ, FsAction.READ);
43        boolean isMkdirs = fileSystem.mkdirs(new Path("hdfs://node01:8020/lqc/dir3"), fsPermission);
44
45        if (isMkdirs) {
46            System.out.println("目录创建成功");
47        }
48
49        fileSystem.close();
50    }
51
52    /**
53     * 说明:将文件hello.txt上传到/lqc/dir1
54     *
55     * 如果路径/lqc/dir1不存在,那么结果是:
56     * 在hdfs上先创建/kaikeba目录,然后将upload.txt上传到/lqc,并将文件upload.txt重命名为dir1
57     *
58     * 如果路径/lqc/dir1存在,那么将hello.txt上传到此路径中去
59     */
60    @Test
61    public void uploadFile2HDFS() throws IOException {
62        Configuration configuration = new Configuration();
63        configuration.set("fs.defaultFS", "hdfs://node01:8020");
64        FileSystem fs = FileSystem.get(configuration);
65
66        Path uploadPath = new Path("/lqc/dir1");
67
68        boolean dir1IsExist = fs.exists(uploadPath);
69        if(!dir1IsExist){
70            boolean mkdirs = fs.mkdirs(uploadPath);
71            if(mkdirs){
72                System.out.println(uploadPath + " 已经创建");
73            }
74        }
75
76        fs.copyFromLocalFile(new Path("D:\\IDEA_WorkSpace\\hadoopstudy\\hello.txt"), uploadPath);//hdfs路径
77        fs.close();
78    }
79
80    // 文件下载, 有校验机制crc
81    @Test
82    public void downloadFileFromHDFS() throws IOException {
83        Configuration configuration = new Configuration();
84        configuration.set("fs.defaultFS", "hdfs://node01:8020");
85        FileSystem fileSystem = FileSystem.get(configuration);
86
87
88        fileSystem.copyToLocalFile(new Path("hdfs://node01:8020/lqc/dir1/hello.txt"),
89                new Path("file:///D:\\IDEA_WorkSpace\\hadoopstudy\\downloads\\hello.txt"));
90
91        //删除文件
92        //fileSystem.delete()
93        //重命名文件
94        //fileSystem.rename()
95        fileSystem.close();
96    }
HDFS datanode 工作机制
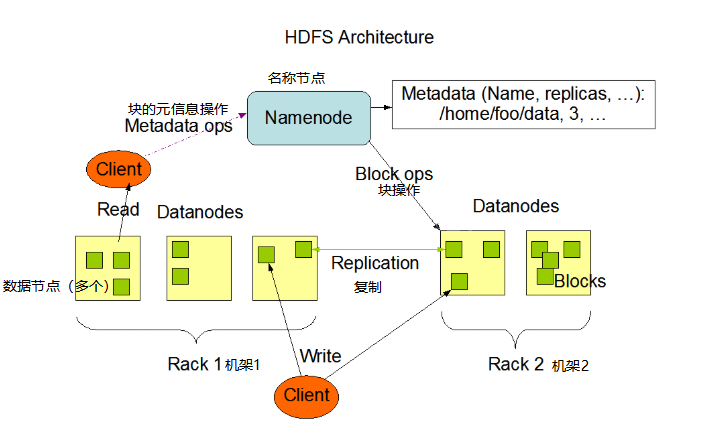
datanode 工作机制
1、datanode 是存放数据的节点,数据以 block 形式存放,每个 block 对应一个元信息文件。
- block 中存储的是数据
- 元信息(.meta)中存储的是 block 的长度,数据校验,时间戳等信息
2、datanode 启动后会向 namenode 注册,然后周期性(6 小时)的向 namenode 汇报存储的信息
3、定期与 namenode 进行心跳检测
4、集群环境中可以动态添加和退出 datanode
数据完整性
1、当客户端向 HDFS 写数据时,使用数据校验(CRC)确保网络传输过程中数据不出问题
2、datanode 读取到数据就进行校验 checksum,如果 checksum 不一样说明 block 已经损坏
3、datanode 对其上创建的文件进行周期性的校验(验证 checksum)
HDFS 读写流程
上传文件流程
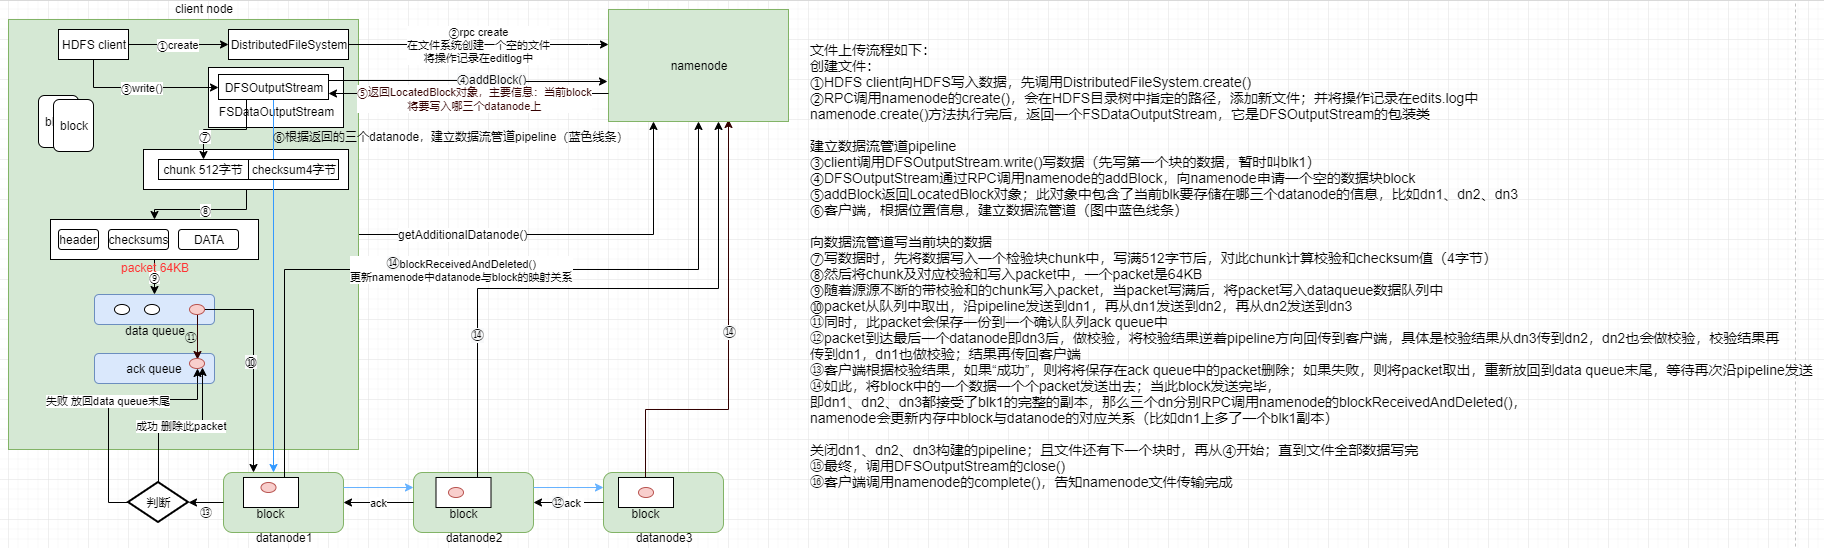
文件上传流程如下:
-
创建文件: ①HDFS client 向 HDFS 写入数据,先调用 DistributedFileSystem.create() ②RPC 调用 namenode 的 create(),会在 HDFS 目录树中指定的路径,添加新文件;并将操作记录在 edits.log 中 namenode.create()方法执行完后,返回一个 FSDataOutputStream,它是 DFSOutputStream 的包装类
-
建立数据流管道 pipeline ③client 调用 DFSOutputStream.write()写数据(先写第一个块的数据,暂时叫 blk1) ④DFSOutputStream 通过 RPC 调用 namenode 的 addBlock,向 namenode 申请一个空的数据块 block ⑤addBlock 返回 LocatedBlock 对象;此对象中包含了当前 blk 要存储在哪三个 datanode 的信息,比如 dn1、dn2、dn3 ⑥ 客户端,根据位置信息,建立数据流管道(图中蓝色线条)
-
向数据流管道写当前块的数据 ⑦ 写数据时,先将数据写入一个检验块 chunk 中,写满 512 字节后,对此 chunk 计算校验和 checksum 值(4 字节) ⑧ 然后将 chunk 及对应校验和写入 packet 中,一个 packet 是 64KB ⑨ 随着源源不断的带校验和的 chunk 写入 packet,当 packet 写满后,将 packet 写入 dataqueue 数据队列中 ⑩packet 从队列中取出,沿 pipeline 发送到 dn1,再从 dn1 发送到 dn2,再从 dn2 发送到 dn3 ⑪ 同时,此 packet 会保存一份到一个确认队列 ack queue 中 ⑫packet 到达最后一个 datanode 即 dn3 后,做校验,将校验结果逆着 pipeline 方向回传到客户端,具体是校验结果从 dn3 传到 dn2,dn2 也会做校验,校验结果再 传到 dn1,dn1 也做校验;结果再传回客户端 ⑬ 客户端根据校验结果,如果“成功”,则将将保存在 ack queue 中的 packet 删除;如果失败,则将 packet 取出,重新放回到 data queue 末尾,等待再次沿 pipeline 发送 ⑭ 如此,将 block 中的一个数据一个个 packet 发送出去;当此 block 发送完毕, 即 dn1、dn2、dn3 都接受了 blk1 的完整的副本,那么三个 dn 分别 RPC 调用 namenode 的 blockReceivedAndDeleted(), namenode 会更新内存中 block 与 datanode 的对应关系(比如 dn1 上多了一个 blk1 副本)
-
关闭 dn1、dn2、dn3 构建的 pipeline;且文件还有下一个块时,再从 ④ 开始;直到文件全部数据写完 ⑮ 最终,调用 DFSOutputStream 的 close() ⑯ 客户端调用 namenode 的 complete(),告知 namenode 文件传输完成
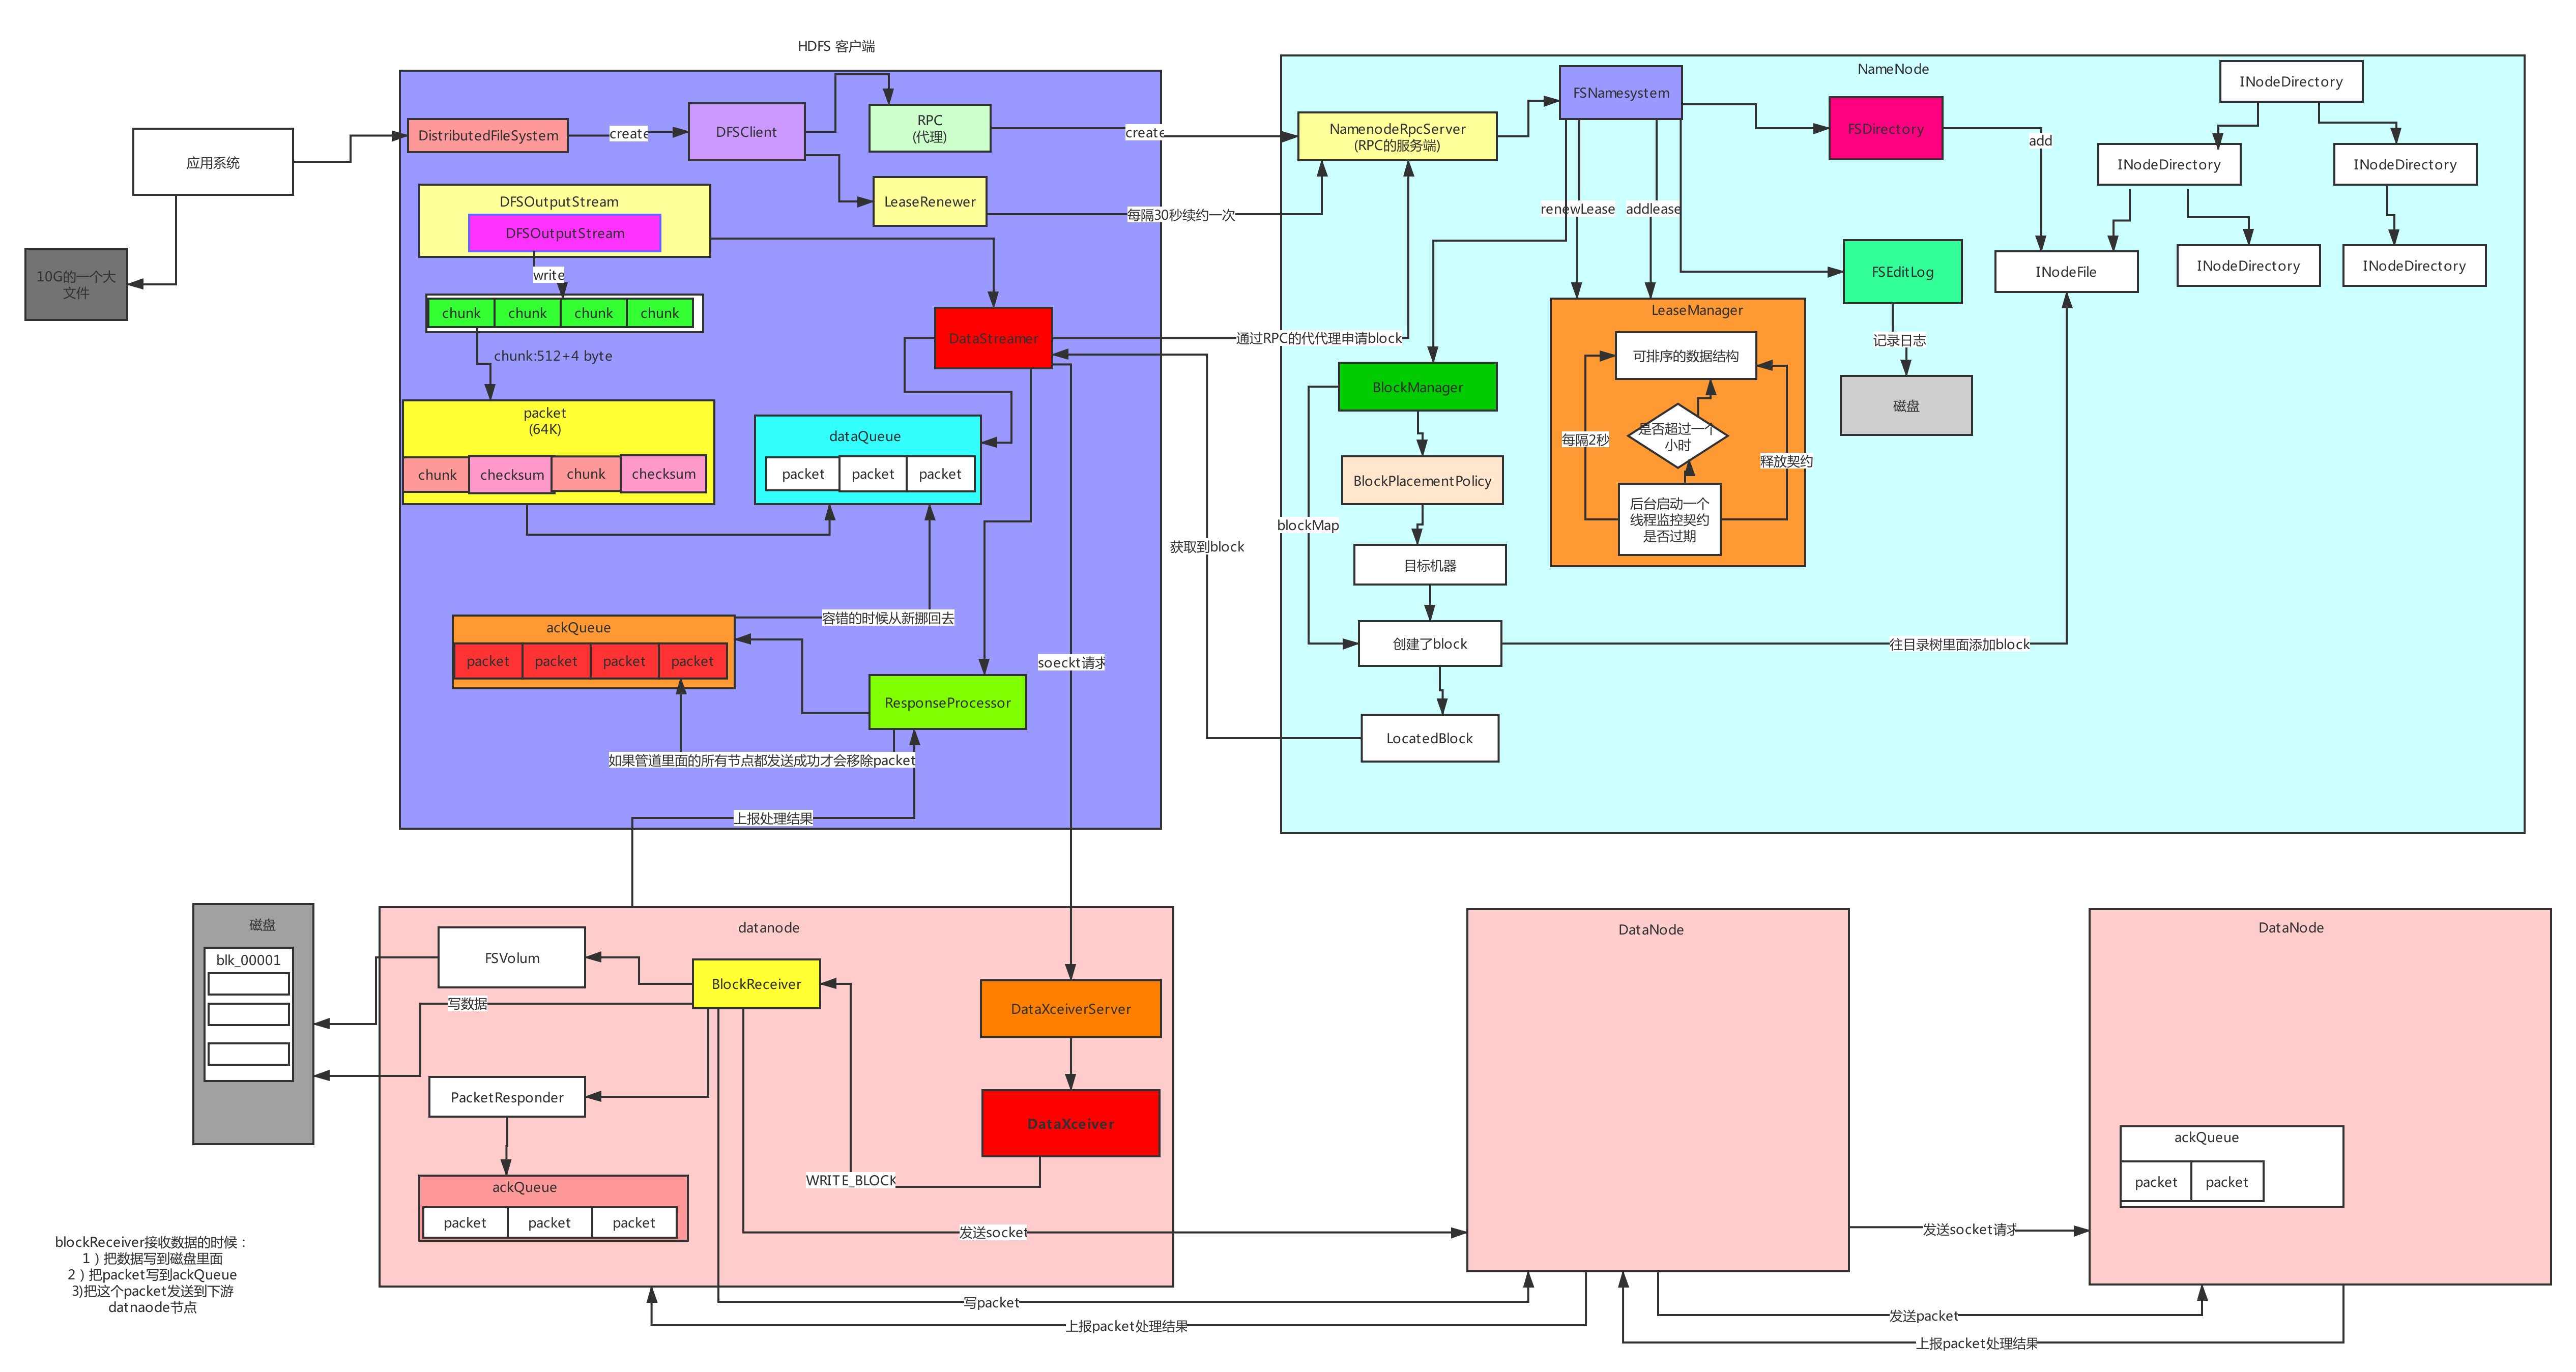
HDFS 上传文件源码分析图:
读取文件流程

1、client 端读取 HDFS 文件,client 调用文件系统对象 DistributedFileSystem 的 open 方法
2、返回 FSDataInputStream 对象(对 DFSInputStream 的包装)
3、构造 DFSInputStream 对象时,调用 namenode 的 getBlockLocations 方法,获得 file 的开始若干 block(如 blk1, blk2, blk3, blk4)的存储 datanode(以下简称 dn)列表;针对每个 block 的 dn 列表,会根据网络拓扑做排序,离 client 近的排在前;
4、调用 DFSInputStream 的 read 方法,先读取 blk1 的数据,与 client 最近的 datanode 建立连接,读取数据
5、读取完后,关闭与 dn 建立的流
6、读取下一个 block,如 blk2 的数据(重复步骤 4、5、6)
7、这一批 block 读取完后,再读取下一批 block 的数据(重复 3、4、5、6、7)
8、完成文件数据读取后,调用 FSDataInputStream 的 close 方法
namenode 与 secondaryName 解析
- NameNode 主要负责集群当中的元数据信息管理,而且元数据信息需要经常随机访问,因为元数据信息必须高效的检索
- 元数据信息保存在哪里能够==快速检索==呢?
- 如何保证元数据的持久安全呢?
- 为了保证元数据信息的快速检索,那么我们就必须将元数据存放在内存当中,因为在内存当中元数据信息能够最快速的检索,那么随着元数据信息的增多(每个 block 块大概占用 150 字节的元数据信息),内存的消耗也会越来越多。
- 如果所有的元数据信息都存放内存,服务器断电,内存当中所有数据都消失,为了保证元数据的安全持久,元数据信息必须做可靠的持久化
- 在 hadoop 当中为了持久化存储元数据信息,将所有的元数据信息保存在了 FSImage 文件当中,那么 FSImage 随着时间推移,必然越来越膨胀,FSImage 的操作变得越来越难,为了解决元数据信息的增删改,hadoop 当中还引入了元数据操作日志 edits 文件,edits 文件记录了客户端操作元数据的信息,随着时间的推移,edits 信息也会越来越大,为了解决 edits 文件膨胀的问题,hadoop 当中引入了 secondaryNamenode 来专门做 fsimage 与 edits 文件的合并

namenode 工作机制
(1)第一次启动 namenode 格式化后,创建 fsimage 和 edits 文件。如果不是第一次启动,直接加载编辑日志和镜像文件到内存。 (2)客户端对元数据进行增删改的请求 (3)namenode 记录操作日志,更新滚动日志。 (4)namenode 在内存中对数据进行增删改查
Secondary NameNode 工作
(1)Secondary NameNode 询问 namenode 是否需要 checkpoint。直接带回 namenode 是否检查结果。 (2)Secondary NameNode 请求执行 checkpoint。 (3)namenode 滚动正在写的 edits 日志 (4)将滚动前的编辑日志和镜像文件拷贝到 Secondary NameNode (5)Secondary NameNode 加载编辑日志和镜像文件到内存,并合并。 (6)生成新的镜像文件 fsimage.chkpoint (7) 拷贝 fsimage.chkpoint 到 namenode (8)namenode 将 fsimage.chkpoint 重新命名成 fsimage
| 属性 | 值 | 解释 |
|---|---|---|
| dfs.namenode.checkpoint.period | 3600 秒(即 1 小时) | The number of seconds between two periodic checkpoints. |
| dfs.namenode.checkpoint.txns | 1000000 | The Secondary NameNode or CheckpointNode will create a checkpoint of the namespace every ‘dfs.namenode.checkpoint.txns’ transactions, regardless of whether ‘dfs.namenode.checkpoint.period’ has expired. |
| dfs.namenode.checkpoint.check.period | 60 秒(1 分钟) | The SecondaryNameNode and CheckpointNode will poll the NameNode every ‘dfs.namenode.checkpoint.check.period’ seconds to query the number of uncheckpointed transactions. |
FSImage 与 edits 详解
- 所有的元数据信息都保存在了 FsImage 与 Eidts 文件当中,这两个文件就记录了所有的数据的元数据信息,元数据信息的保存目录配置在了 hdfs-site.xml 当中
 1<!-- fsimage目录 -->
 2<property>
 3  <name>dfs.namenode.name.dir</name>
 4  <value>file:///kkb/install/hadoop-2.6.0-cdh5.14.2/hadoopDatas/namenodeDatas</value>
 5</property>
 6<!-- edit文件目录 -->
 7<property>
 8   <name>dfs.namenode.edits.dir</name>
 9   <value>file:///kkb/install/hadoop-2.6.0-cdh5.14.2/hadoopDatas/dfs/nn/edits</value>
10</property>
-
客户端对 hdfs 进行写文件时会首先被记录在 edits 文件中
edits 修改时元数据也会更新。
每次 hdfs 更新时 edits 先更新后,客户端才会看到最新信息。
fsimage:是 namenode 中关于元数据的镜像,一般称为检查点。
一般开始时对 namenode 的操作都放在 edits 中,为什么不放在 fsimage 中呢?
因为 fsimage 是 namenode 的完整的镜像,内容很大,如果每次都加载到内存的话生成树状拓扑结构,这是非常耗内存和 CPU。
fsimage 内容包含了 namenode 管理下的所有 datanode 中文件及文件 block 及 block 所在的 datanode 的元数据信息。随着 edits 内容增大,就需要在一定时间点和 fsimage 合并。
FSimage 文件当中的文件信息查看
-
使用命令 hdfs oiv
1cd  /kkb/install/hadoop-2.6.0-cdh5.14.2/hadoopDatas/namenodeDatas/current
2hdfs oiv    #查看帮助信息
3hdfs oiv -i fsimage_0000000000000000864 -p XML -o /home/hadoop/fsimage1.xml
edits 当中的文件信息查看
-
查看命令 hdfs oev
1cd /kkb/install/hadoop-2.6.0-cdh5.14.2/hadoopDatas/dfs/nn/edits/current
2hdfs oev     #查看帮助信息
3hdfs oev -i edits_0000000000000000865-0000000000000000866 -o /home/hadoop/myedit.xml -p XML
mapreduce
MapReduce 编程模型
-
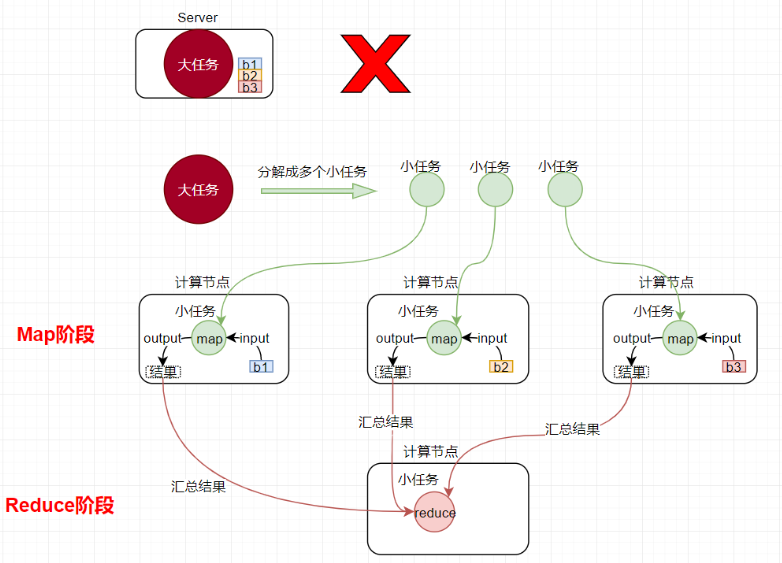
MapReduce 是采用一种分而治之的思想设计出来的分布式计算框架
-
那什么是分而治之呢?
- 比如一个复杂、计算量大、耗时长的任务,暂且称为“大任务”;
- 当单台服务器无法计算或无法在较短时间内计算出结果时,可将此大任务切分成一个个小的任务,小任务分别在不同的服务器上并行执行;
- 最终再汇总每个小任务的结果
-
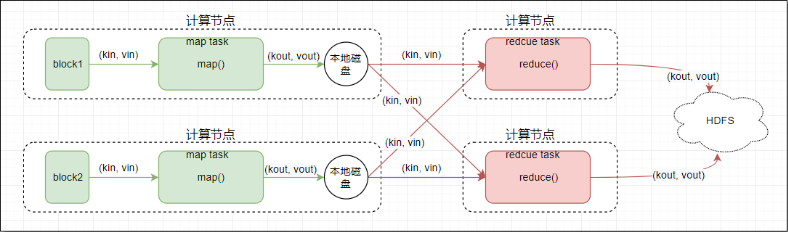
MapReduce 由两个阶段组成:
- Map 阶段(切分成一个个小的任务)
- Reduce 阶段(汇总小任务的结果)
mapreduce 编程步骤
1. Map 阶段 2 个步骤
-
第一步:设置 InputFormat 类,将数据切分成 key,value 对;此 kv 对作为第二步的输入
-
第二步:自定义 map 逻辑,处理第一步传过来的 kv 对数据,然后转换成新的 key,value 对,并输出
2. shuffle 阶段 4 个步骤
-
第三步:对上一步输出的 key,value 对进行分区。(相同 key 的 kv 对属于同一分区)
-
第四步:对每个分区的数据按照 key 进行排序
-
第五步:对分区中的数据进行规约(combine 操作),降低数据的网络拷贝(可选步骤)
-
第六步:对排序后的 kv 对数据进行分组;分组的过程中,key 相同的 kv 对为一组;将同一组的 kv 对的所有 value 放到一个集合当中(每组数据调用一次 reduce 方法)
3. reduce 阶段 2 个步骤
-
第七步:对多个 map 的任务进行合并,排序,写 reduce 函数自己的逻辑,对输入的 key,value 对进行处理,转换成新的 key,value 对进行输出
-
第八步:设置将输出的 key,value 对数据保存到文件中
hadoop 当中常用的数据类型
Hadoop 没有使用 Java 自带的数据类型,而是自己封装了一套数据类型,这些数据类型更利于持久化和网络传输。
| Java 类型 | Hadoop Writable 类型 |
|---|---|
| Boolean | BooleanWritable |
| Byte | ByteWritable |
| Int | IntWritable |
| Float | FloatWritable |
| Long | LongWritable |
| Double | DoubleWritable |
| String | Text |
| Map | MapWritable |
| Array | ArrayWritable |
| byte[] | BytesWritable |
mapreduce main 程序
 1import org.apache.hadoop.conf.Configuration;
 2import org.apache.hadoop.conf.Configured;
 3import org.apache.hadoop.fs.FileSystem;
 4import org.apache.hadoop.fs.Path;
 5import org.apache.hadoop.io.IntWritable;
 6import org.apache.hadoop.io.Text;
 7import org.apache.hadoop.mapreduce.Job;
 8import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
 9import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
10import org.apache.hadoop.util.Tool;
11import org.apache.hadoop.util.ToolRunner;
12
13/**
14 * 这个类作为mr程序的入口类,这里面写main方法
15 */
16public class WordCount extends Configured implements Tool {
17    /**
18     * 实现Tool接口之后,需要实现一个run方法,
19     * 这个run方法用于组装我们的程序的逻辑,其实就是组装八个步骤
20     *
21     * @param args
22     * @return
23     * @throws Exception
24     */
25    @Override
26    public int run(String[] args) throws Exception {
27        /***
28         * 第一步:读取文件,解析成key,value对,k1   v1
29         * 第二步:自定义map逻辑,接受k1   v1  转换成为新的k2   v2输出
30         * 第三步:分区。相同key的数据发送到同一个reduce里面去,key合并,value形成一个集合
31         * 第四步:排序   对key2进行排序。字典顺序排序
32         * 第五步:规约  combiner过程  调优步骤 可选
33         * 第六步:分组
34         * 第七步:自定义reduce逻辑接受k2   v2  转换成为新的k3   v3输出
35         * 第八步:输出k3  v3 进行保存
36         */
37
38        //获取Job对象,组装我们的八个步骤,每一个步骤都是一个class类
39        Configuration conf = super.getConf();
40
41        Job job = Job.getInstance(conf, WordCount.class.getSimpleName());
42
43        //判断输出路径,是否存在,如果存在,则删除
44        FileSystem fileSystem = FileSystem.get(conf);
45        if (fileSystem.exists(new Path(args[1]))) {
46            fileSystem.delete(new Path(args[1]), true);
47        }
48
49        //实际工作当中,程序运行完成之后一般都是打包到集群上面去运行,打成一个jar包
50        //如果要打包到集群上面去运行,必须添加以下设置
51        job.setJarByClass(WordCount.class);
52
53        //第一步:读取文件,解析成key,value对,k1:行偏移量  v1:一行文本内容
54        job.setInputFormatClass(TextInputFormat.class);
55        //指定我们去哪一个路径读取文件
56//        TextInputFormat.addInputPath(job,new Path("file:///C:\\Users\\admin\\Desktop\\wordCount_input\\数据"));
57        TextInputFormat.addInputPath(job, new Path(args[0]));
58
59        //第二步:自定义map逻辑,接受k1   v1  转换成为新的k2   v2输出
60        job.setMapperClass(MyMapper.class);
61        //设置map阶段输出的key,value的类型,其实就是k2  v2的类型
62        job.setMapOutputKeyClass(Text.class);
63        job.setMapOutputValueClass(IntWritable.class);
64
65        //第三步到六步:分区,排序,规约,分组都省略
66
67        //第七步:自定义reduce逻辑
68        job.setReducerClass(MyReducer.class);
69        //设置key3  value3的类型
70        job.setOutputKeyClass(Text.class);
71        job.setOutputValueClass(IntWritable.class);
72
73        //第八步:输出k3  v3 进行保存
74        job.setOutputFormatClass(TextOutputFormat.class);
75        //一定要注意,输出路径是需要不存在的,如果存在就报错
76//        TextInputFormat.addInputPath(job,new Path("file:///C:\\Users\\admin\\Desktop\\wordCount_output"));
77        TextOutputFormat.setOutputPath(job, new Path(args[1]));
78
79        job.setNumReduceTasks(3);
80
81        //提交job任务
82        boolean b = job.waitForCompletion(true);
83        return b ? 0 : 1;
84    }
85
86    /*
87    作为程序的入口类
88     */
89    public static void main(String[] args) throws Exception {
90        Configuration configuration = new Configuration();
91
92        //提交run方法之后,得到一个程序的退出状态码
93        int run = ToolRunner.run(configuration, new WordCount(), args);
94        //根据我们 程序的退出状态码,退出整个进程
95        System.exit(run);
96    }
97}
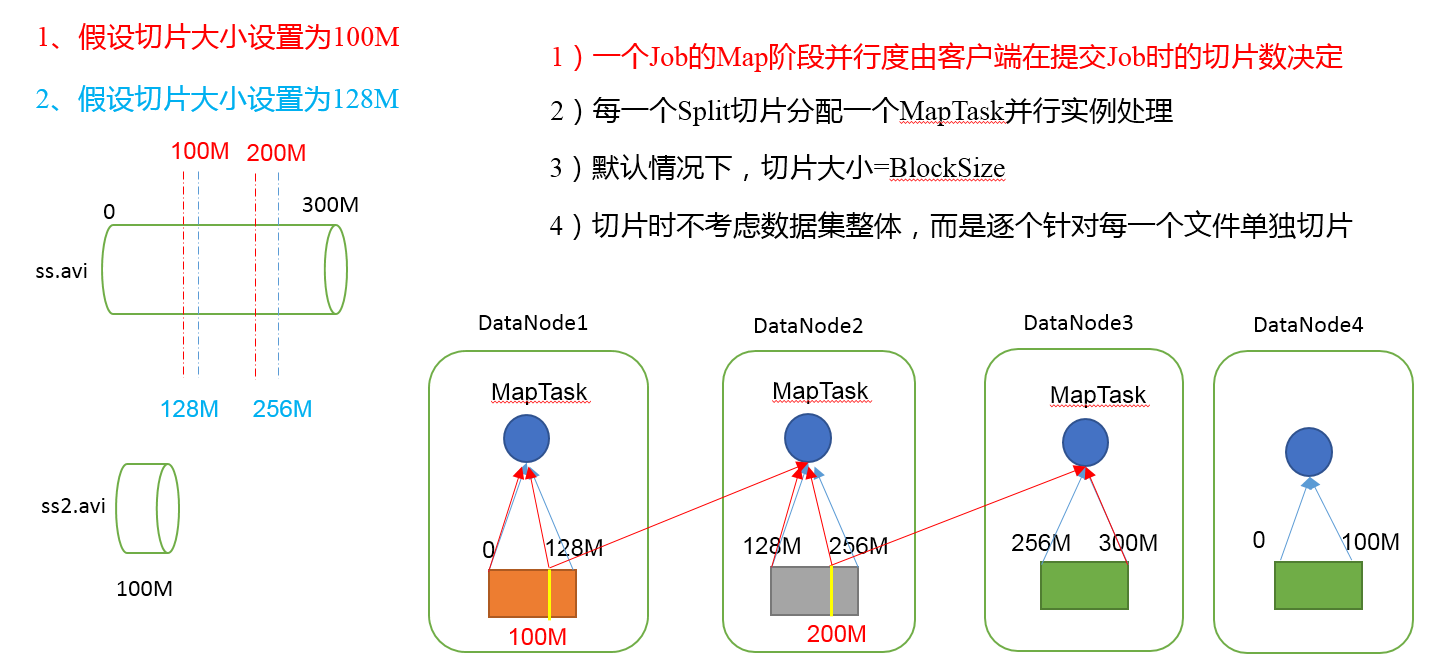
map task 数量及切片机制
mapreduce 的 InputFormat
除了 MapReduce 提供的这些输入类,还可以自定义输入类。
实现步骤:
- 继承 FileInputFormat
- 实现方法,核心是返回 RecordReader 对象,因此还需要实现一个 RecordReader 类
| 类名 | 主要作用 |
|---|---|
| TextInputFormat | 读取文本文件 |
| CombineFileInputFormat | 在 MR 当中用于合并小文件,将多个小文件合并之后只需要启动一个 mapTask 进行运行 |
| SequenceFileInputFormat | 处理 SequenceFile 这种格式的数据 |
| KeyValueTextInputFormat | 通过手动指定分隔符,将每一条数据解析成为 key,value 对类型 |
| NLineInputFormat | 指定数据的行数作为一个切片 |
| FixedLengthInputFormat | 文件的每个 record 是固定的长度;用于读取固定宽度的二进制记录 |
实现 Mapper 方法
 1import org.apache.hadoop.io.BytesWritable;
 2import org.apache.hadoop.io.NullWritable;
 3import org.apache.hadoop.io.Text;
 4import org.apache.hadoop.mapreduce.Mapper;
 5import org.apache.hadoop.mapreduce.lib.input.FileSplit;
 6
 7import java.io.IOException;
 8
 9public class MyMapper extends Mapper<NullWritable, BytesWritable, Text, BytesWritable> {
10    /**
11     * @param key
12     * @param value   小文件的全部内容
13     * @param context 上下文,用来写出OUTKEY,OUTVALUE
14     */
15    @Override
16    protected void map(NullWritable key, BytesWritable value, Context context) throws IOException, InterruptedException {
17        //文件名
18        FileSplit inputSplit = (FileSplit) context.getInputSplit();
19        String name = inputSplit.getPath().getName();
20        context.write(new Text(name), value);
21    }
22}
实现 reducer
实现 reducer 时,注意输入输出,reducer 的输入是 mapper 的输出,reducer 的输出是 OutputFormat 的输入。
在 reducer 中主要进行的操作是实现累加,累加这个过程可以加入一些处理逻辑。
实现 reducer 示例:
 1import org.apache.hadoop.io.IntWritable;
 2import org.apache.hadoop.io.Text;
 3import org.apache.hadoop.mapreduce.Reducer;
 4
 5import java.io.IOException;
 6
 7/**
 8 * reduce求和计算,combine的时候也可以用此类
 9 */
10public class AnalysisReducer extends Reducer<Text, IntWritable, Text, IntWritable> {
11    @Override
12    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {
13        int sum = 0;
14        for (IntWritable v : values) {
15            sum += v.get();
16        }
17        context.write(key, new IntWritable(sum));
18    }
19}
mapreduce 分区
分区需要继承 Partitioner 接口,实现 getPartition 方法。
- 在 mapreduce 执行当中,有一个默认的步骤就是 partition 分区;
- 分区主要的作用就是默认将 key 相同的 kv 对数据发送到同一个分区中;
- 在 mapreduce 当中有一个抽象类叫做 Partitioner,默认使用的实现类是 HashPartitioner,我们可以通过 HashPartitioner 的源码,查看到分区的逻辑如下
- MR 编程的第三步就是分区;这一步中决定了 map 生成的每个 kv 对,被分配到哪个分区里
为 job 设置分区器:
1job.setPartitionerClass(MyPartitioner.class);
mapreduce 的排序
mapreduce 在 map 计算和分区处理后会对分区中的内容进行排序,默认对 key 进行排序(按字典序)。
-
对于 MapTask
- 它会将处理的结果暂时放到环形缓冲区中,当环形缓冲区使用率达到一定阈值后,再对缓冲区中的数据进行一次快速排序
- 并将这些有序数据溢写到磁盘上
- 而当数据处理完毕后,它会对磁盘上所有文件进行归并排序。
-
对于 ReduceTask,它从每个执行完成的 MapTask 上远程拷贝相应的数据文件
- 如果文件大小超过一定阈值,则溢写磁盘上,否则存储在内存中。
- 如果磁盘上文件数目达到一定阈值,则进行一次归并排序以生成一个更大文件;
- 如果内存中文件大小或者数目超过一定阈值,则进行一次合并后将数据溢写到磁盘上。
- 当所有数据拷贝完毕后,ReduceTask 统一对内存和磁盘上的所有数据进行一次归并排序。
自定义排序
自定义排序需要单独创建 map 和 reduce 输入输出时 key 使用的 JavaBean 对象,这个对象需要实现序列化和比较接口。
JavaBean 示例:
 1import org.apache.hadoop.io.WritableComparable;
 2
 3import java.io.DataInput;
 4import java.io.DataOutput;
 5import java.io.IOException;
 6
 7//bean要能够可序列化且可比较,所以需要实现接口WritableComparable
 8public class MyBean implements WritableComparable<FlowSortBean> {
 9    int a;
10    int b;
11
12    @Override
13    public int compareTo(FlowSortBean o) {
14        // 实现比较逻辑,返回正数、0、负数
15        return a-o.a
16    }
17
18    //序列化,注意:写入写出顺序一定要相同
19    @Override
20    public void write(DataOutput out) throws IOException {
21        out.writeInt(a);
22        out.writeInt(b);
23    }
24
25    //反序列化
26    @Override
27    public void readFields(DataInput in) throws IOException {
28        this.a = in.readInt();
29        this.b = in.readInt();
30    }
31}
mapreduce 分组
实现分组需要实现 GroupingComparator 类。
关键类 GroupingComparator
- 决定了 mapreduce 当中 reduce 端哪些数据作为一组,每一组调用一次 reduce 的逻辑
- 默认是 key 相同的 kv 对,作为同一组;每组调用一次 reduce 方法
- 通过实现 GroupingComparator 接口,实现自定义的分组逻辑
步骤:
1、继承 WritableComparator 2、重写 compare()方法
1@Override
2public int compare(WritableComparable a, WritableComparable b) {
3        // 比较的业务逻辑
4        return result;
5}
3、创建一个构造器,将比较对象的类传给父类
1protected OrderGroupingComparator() {
2        super(OrderBean.class, true);
3}
计数器与累加器
-
计数器是收集作业统计信息的有效手段之一,用于质量控制或应用级统计。计数器还可辅助诊断系统故障。如果需要将日志信息传输到 map 或 reduce 任务, 更好的方法通常是看能否用一个计数器值来记录某一特定事件的发生。对于大型分布式作业而言,使用计数器更为方便。除了因为获取计数器值比输出日志更方便,还有根据计数器值统计特定事件的发生次数要比分析一堆日志文件容易得多。
-
hadoop 内置计数器列表
| MapReduce 任务计数器 | org.apache.hadoop.mapreduce.TaskCounter |
|---|---|
| 文件系统计数器 | org.apache.hadoop.mapreduce.FileSystemCounter |
| FileInputFormat 计数器 | org.apache.hadoop.mapreduce.lib.input.FileInputFormatCounter |
| FileOutputFormat 计数器 | org.apache.hadoop.mapreduce.lib.output.FileOutputFormatCounter |
| 作业计数器 | org.apache.hadoop.mapreduce.JobCounter |
计数器使用:
定义计数器(Counter),通过 context 上下文对象可以获取我们的计数器,进行记录。
 1import org.apache.hadoop.io.LongWritable;
 2import org.apache.hadoop.io.NullWritable;
 3import org.apache.hadoop.io.Text;
 4import org.apache.hadoop.mapreduce.Counter;
 5import org.apache.hadoop.mapreduce.Mapper;
 6
 7import java.io.IOException;
 8
 9public class MyMapper extends Mapper<LongWritable, Text, FlowSortBean, NullWritable> {
10
11    @Override
12    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
13        //自定义我们的计数器,这里实现了统计map输入数据的条数
14        Counter counter = context.getCounter("MR_COUNT", "MapRecordCounter");
15        counter.increment(1L);
16	//...
17    }
18}
map task 工作机制
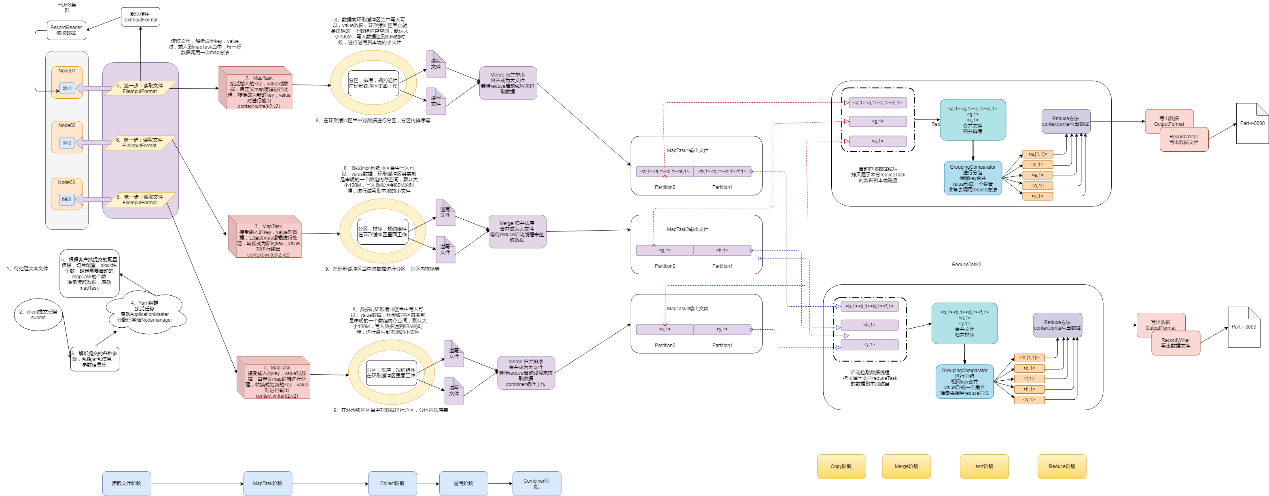
-
(1)Read 阶段:MapTask 通过用户编写的 RecordReader,从输入 InputSplit 中解析出一个个 key/value。
-
(2)Map 阶段:该节点主要是将解析出的 key/value 交给用户编写 map()函数处理,并产生一系列新的 key/value。
-
(3)Collect 收集阶段:在用户编写 map()函数中,当数据处理完成后,一般会调用 OutputCollector.collect()输出结果。在该函数内部,它会将生成的 key/value 分区(调用 Partitioner),并写入一个环形内存缓冲区中。
-
(4)Spill 阶段:即“溢写”,当环形缓冲区满 80%后,MapReduce 会将数据写到本地磁盘上,生成一个临时文件。需要注意的是,将数据写入本地磁盘之前,先要对数据进行一次本地排序,并在必要时对数据进行合并、压缩等操作。
-
溢写阶段详情:
-
步骤 1:利用快速排序算法对缓存区内的数据进行排序,排序方式是,先按照分区编号 Partition 进行排序,然后按照 key 进行排序。这样,经过排序后,数据以分区为单位聚集在一起,且同一分区内所有数据按照 key 有序。
-
步骤 2:按照分区编号由小到大依次将每个分区中的数据写入任务工作目录下的临时文件 output/spillN.out(N 表示当前溢写次数)中。如果用户设置了 Combiner,则写入文件之前,对每个分区中的数据进行一次聚集操作。
-
步骤 3:将分区数据的元信息写到内存索引数据结构 SpillRecord 中,其中每个分区的元信息包括,在临时文件中的偏移量、压缩前数据大小和压缩后数据大小。如果当前内存索引大小超过 1MB,则将内存索引写到文件 output/spillN.out.index 中。
-
(5)合并阶段:当所有数据处理完成后,MapTask 对所有临时文件进行一次合并,以确保最终只会生成一个数据文件。
-
当所有数据处理完后,MapTask 会将所有临时文件合并成一个大文件,并保存到文件 output/file.out 中,同时生成相应的索引文件 output/file.out.index。
-
在进行文件合并过程中,MapTask 以分区为单位进行合并。对于某个分区,它将采用多轮递归合并的方式。每轮合并 io.sort.factor(默认 10)个文件,并将产生的文件重新加入待合并列表中,对文件排序后,重复以上过程,直到最终得到一个大文件。
-
让每个 MapTask 最终只生成一个数据文件,可避免同时打开大量文件和同时读取大量小文件产生的随机读取带来的开销。
-
reduce 工作机制
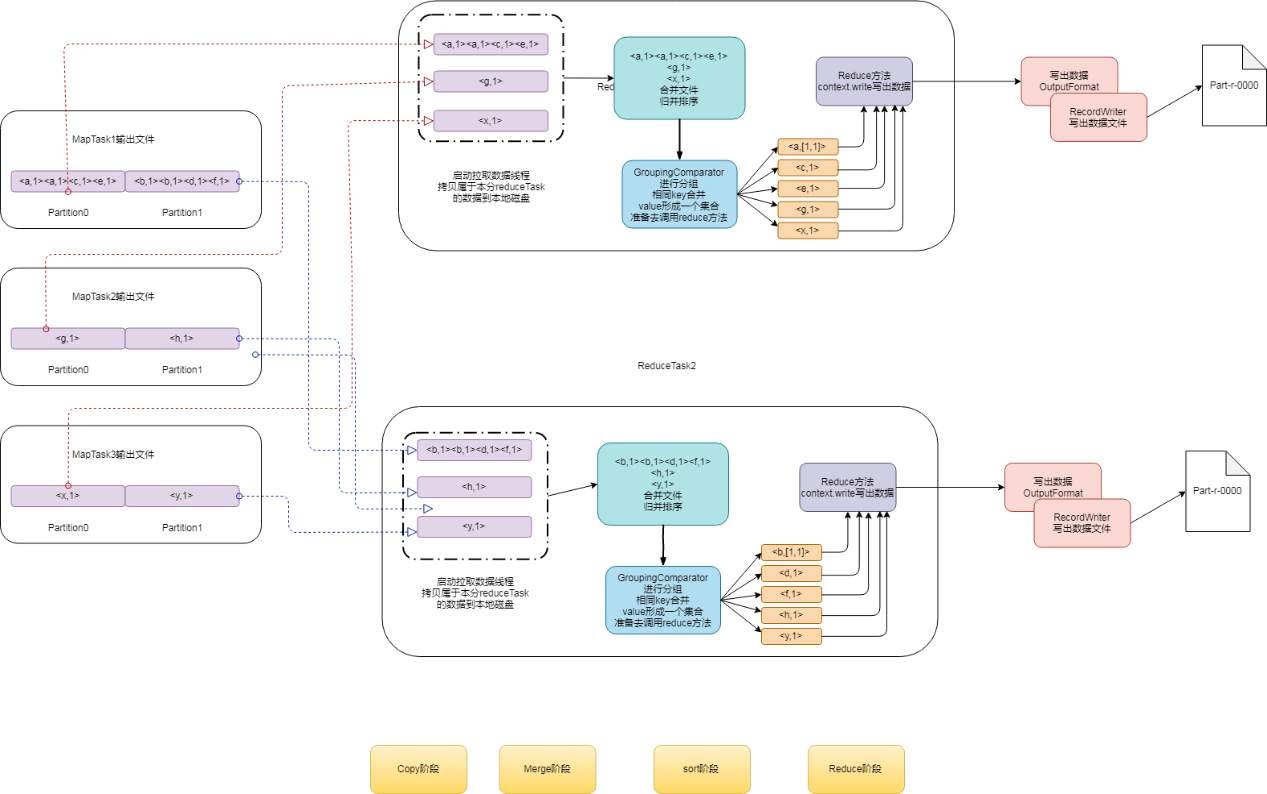
-
(1)Copy 阶段:ReduceTask 从各个 MapTask 上远程拷贝一片数据,并针对某一片数据,如果其大小超过一定阈值,则写到磁盘上,否则直接放到内存中。
-
(2)Merge 阶段:在远程拷贝数据的同时,ReduceTask 启动了两个后台线程对内存和磁盘上的文件进行合并,以防止内存使用过多或磁盘上文件过多。
-
(3)Sort 阶段:当所有 map task 的分区数据全部拷贝完,按照 MapReduce 语义,用户编写 reduce()函数输入数据是按 key 进行聚集的一组数据。为了将 key 相同的数据聚在一起,Hadoop 采用了基于排序的策略。由于各个 MapTask 已经实现对自己的处理结果进行了局部排序,因此,ReduceTask 只需对所有数据进行一次归并排序即可。
-
(4)Reduce 阶段:reduce()函数将计算结果写到 HDFS 上。
设置 ReduceTask 并行度(个数)
ReduceTask 的并行度同样影响整个 Job 的执行并发度和执行效率,但与 MapTask 的并发数由切片数决定不同,ReduceTask 数量的决定是可以直接手动设置:
1// 默认值是1,手动设置为4
2job.setNumReduceTasks(4);
Hadoop 数据处理实践
以下这个例子是对日志中的登录信息(手机号)进行统计,最后将不同的手机号分类写到文件。
项目依赖 pom.xml
 1    <properties>
 2        <hadoop.version>3.2.2</hadoop.version>
 3    </properties>
 4
 5    <dependencies>
 6        <dependency>
 7            <groupId>org.apache.hadoop</groupId>
 8            <artifactId>hadoop-client</artifactId>
 9            <version>${hadoop.version}</version>
10        </dependency>
11        <dependency>
12            <groupId>org.apache.hadoop</groupId>
13            <artifactId>hadoop-common</artifactId>
14            <version>${hadoop.version}</version>
15        </dependency>
16        <dependency>
17            <groupId>org.apache.hadoop</groupId>
18            <artifactId>hadoop-hdfs</artifactId>
19            <version>${hadoop.version}</version>
20        </dependency>
21
22        <dependency>
23            <groupId>org.apache.hadoop</groupId>
24            <artifactId>hadoop-mapreduce-client-core</artifactId>
25            <version>${hadoop.version}</version>
26        </dependency>
27
28        <!-- https://mvnrepository.com/artifact/junit/junit -->
29        <dependency>
30            <groupId>junit</groupId>
31            <artifactId>junit</artifactId>
32            <version>4.12</version>
33            <!--<scope>test</scope>-->
34        </dependency>
35
36        <dependency>
37            <groupId>org.testng</groupId>
38            <artifactId>testng</artifactId>
39            <version>RELEASE</version>
40        </dependency>
41
42        <dependency>
43            <groupId>log4j</groupId>
44            <artifactId>log4j</artifactId>
45            <version>1.2.17</version>
46        </dependency>
47
48    </dependencies>
49
50    <build>
51        <plugins>
52            <plugin>
53                <groupId>org.apache.maven.plugins</groupId>
54                <artifactId>maven-compiler-plugin</artifactId>
55                <version>3.0</version>
56                <configuration>
57                    <source>1.8</source>
58                    <target>1.8</target>
59                    <encoding>UTF-8</encoding>
60                    <!--   <verbal>true</verbal>-->
61                </configuration>
62            </plugin>
63            <plugin>
64                <groupId>org.apache.maven.plugins</groupId>
65                <artifactId>maven-shade-plugin</artifactId>
66                <version>2.4.3</version>
67                <executions>
68                    <execution>
69                        <phase>package</phase>
70                        <goals>
71                            <goal>shade</goal>
72                        </goals>
73                        <configuration>
74                            <minimizeJar>true</minimizeJar>
75                        </configuration>
76                    </execution>
77                </executions>
78            </plugin>
79        </plugins>
80    </build>
第一步:实现 Mapper
 1import org.apache.hadoop.io.IntWritable;
 2import org.apache.hadoop.io.LongWritable;
 3import org.apache.hadoop.io.Text;
 4import org.apache.hadoop.mapreduce.Mapper;
 5
 6import java.io.IOException;
 7
 8/**
 9 * Description: 截取日志中的手机号
10 *
11 * @author: liuqichun
12 */
13public class AnalysisMapper extends Mapper<LongWritable, Text, Text, IntWritable> {
14
15    @Override
16    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {
17        if(value==null) return;
18        String[] splits = value.toString().split(" ");
19        if (splits.length < 8) return;
20
21        String info = splits[7];
22        if(info != null && !info.isEmpty() && info.contains("【用户登录】")){
23            int lastIndex = info.lastIndexOf(":");
24            String phone = info.substring(lastIndex + 1);
25            if(!phone.isEmpty()){
26                context.write(new Text(phone) ,new IntWritable(1));
27            }
28        }
29    }
30}
第二步:实现 reducer
 1import org.apache.hadoop.io.IntWritable;
 2import org.apache.hadoop.io.Text;
 3import org.apache.hadoop.mapreduce.Reducer;
 4
 5import java.io.IOException;
 6
 7/**
 8 * reduce求和计算,combine的时候也可以用此类
 9 * @author: liuqichun
10 */
11public class AnalysisReducer extends Reducer<Text, IntWritable, Text, IntWritable> {
12    @Override
13    protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {
14        int sum = 0;
15        // 求和
16        for (IntWritable v : values) {
17            sum += v.get();
18        }
19        // 写出
20        context.write(key, new IntWritable(sum));
21    }
22}
第三步:实现分区
 1import org.apache.hadoop.io.IntWritable;
 2import org.apache.hadoop.io.Text;
 3import org.apache.hadoop.mapreduce.Partitioner;
 4
 5/**
 6 * 根据手机号前缀分区,把不同手机号开头结果的放到不同文件
 7 *
 8 * 10~13:A文件
 9 * 14~17:B文件
10 * 18~19:C文件
11 *
12 * @author: liuqichun
13 */
14public class AnalysisPartitioner extends Partitioner<Text, IntWritable> {
15    @Override
16    public int getPartition(Text text, IntWritable intWritable, int numPartitions) {
17        String prefix = text.toString().substring(0, 2);
18        int val = Integer.parseInt(prefix);
19        // 返回分区的索引即可实现分区
20        if(val < 15){
21            return 0;
22        }else if(val<18)
23            return 1;
24        else {
25            return 2;
26        }
27    }
28
29}
第四步:实现 main 程序
 1import org.apache.hadoop.conf.Configuration;
 2import org.apache.hadoop.conf.Configured;
 3import org.apache.hadoop.fs.FileSystem;
 4import org.apache.hadoop.fs.LocatedFileStatus;
 5import org.apache.hadoop.fs.Path;
 6import org.apache.hadoop.fs.RemoteIterator;
 7import org.apache.hadoop.io.IntWritable;
 8import org.apache.hadoop.io.Text;
 9import org.apache.hadoop.mapreduce.Job;
10import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;
11import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;
12import org.apache.hadoop.util.Tool;
13import org.apache.hadoop.util.ToolRunner;
14
15/**
16 * Description: 登录日志分析程序,日志进行分布式处理,统计每个手机号登录登录次数
17 *
18 * @author: liuqichun
19 */
20public class AnalysisMain extends Configured implements Tool {
21
22    public static void main(String[] args) throws Exception {
23        int run = ToolRunner.run(new Configuration(), new AnalysisMain(), args);
24        System.exit(run);
25    }
26
27    @Override
28    public int run(String[] args) throws Exception {
29
30        FileSystem fileSystem = FileSystem.get(super.getConf());
31
32        // 作业job
33        Job job = Job.getInstance(super.getConf(), "AnalysisUserLogin");
34        job.setJarByClass(AnalysisMain.class);
35
36        // 输入数据
37        job.setInputFormatClass(TextInputFormat.class);
38
39        // 读取并过滤文件
40        RemoteIterator<LocatedFileStatus> fileIterator = fileSystem.listFiles(new Path("hdfs://node01:8020/project-log/userlogin"), false);
41        StringBuilder sb = new StringBuilder(2048);
42        while (fileIterator.hasNext()){
43            LocatedFileStatus file = fileIterator.next();
44            String path = file.getPath().toString();
45            if(path.contains("part-r-")){
46                sb.append(path).append(",");
47            }
48        }
49
50        TextInputFormat.addInputPaths(job,sb.substring(0,sb.length()-1));
51
52        // map计算
53        job.setMapperClass(AnalysisMapper.class);
54        job.setMapOutputKeyClass(Text.class);
55        job.setMapOutputValueClass(IntWritable.class);
56
57        // combine, map task中进行reduce
58        job.setCombinerClass(AnalysisReducer.class);
59
60        // 分区
61        job.setPartitionerClass(AnalysisPartitioner.class);
62        // 设置reduce作业数,每个task输出一个文件
63        job.setNumReduceTasks(3);
64
65        // 排序按照默认
66
67        //reduce
68        job.setReducerClass(AnalysisReducer.class);
69        job.setOutputKeyClass(Text.class);
70        job.setOutputValueClass(IntWritable.class);
71
72        // 输出数据
73        job.setOutputFormatClass(TextOutputFormat.class);
74        Path outputPath = new Path("hdfs://node01:8020/project-log/userlogin_output");
75        if (fileSystem.exists(outputPath)) {
76            fileSystem.delete(outputPath,true);
77        }
78
79        TextOutputFormat.setOutputPath(job, outputPath);
80
81        boolean b = job.waitForCompletion(true);
82
83        return b ? 0 : 1;
84    }
85}
第五步:打包提交集群运行
1、在 idea 中将项目打包为 jar
2、运行
1# 格式: hadoop jar <jar包> <mapreduce main程序> [args...]
2hadoop jar original-hadoop-study-1.0-SNAPSHOT.jar com.elltor.userlogincount.analysis.AnalysisMain
3、执行结果
原始日志数据为多个日志文件,部分内容如下:
 1[30mSMPE-ADMIN- 2021-04-09 15:35:54 [http-nio-8001-exec-4] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:15935508617
 2[30mSMPE-ADMIN- 2021-04-09 15:35:54 [http-nio-8001-exec-4] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:15936533317
 3[30mSMPE-ADMIN- 2021-04-13 14:47:52 [http-nio-8000-exec-5] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:15090382096
 4[30mSMPE-ADMIN- 2021-04-14 15:04:28 [http-nio-8000-exec-1] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:13555555555
 5[30mSMPE-ADMIN- 2021-04-14 15:04:28 [http-nio-8000-exec-1] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:13555555555
 6[30mSMPE-ADMIN- 2021-04-17 10:58:20 [http-nio-8000-exec-6] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:18888888888
 7[30mSMPE-ADMIN- 2021-04-17 10:58:20 [http-nio-8000-exec-6] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:18888888888
 8[30mSMPE-ADMIN- 2021-04-17 17:16:47 [http-nio-8000-exec-10] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:18888888888
 9[30mSMPE-ADMIN- 2021-04-20 16:59:19 [http-nio-8000-exec-8] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:15090382096
10[30mSMPE-ADMIN- 2021-04-20 16:59:19 [http-nio-8000-exec-8] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:15090382096
11[30mSMPE-ADMIN- 2021-04-22 17:21:18 [http-nio-8000-exec-3] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:15500000000
12[30mSMPE-ADMIN- 2021-04-22 17:21:18 [http-nio-8000-exec-3] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:15500000000
13[30mSMPE-ADMIN- 2021-04-24 10:27:11 [http-nio-8000-exec-6] INFO m.m.s.c.AuthorizationController - 【用户登录】用户手机号已注册。手机号:15143308338
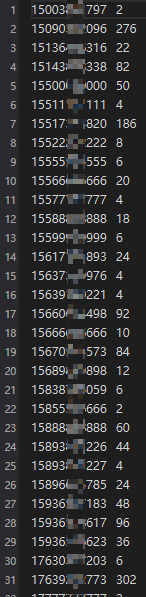
处理后的结果(部分):